Dadurch verschiebt sich die Frage von „Ist etwas kaputt?“ zu „Entwickeln sich die Bedingungen in eine Richtung, die typischerweise zu einem Ausfall führt?“ Risiko wird zu etwas, das frühzeitig erkennbar ist. Und es bleibt noch genug Zeit zum Handeln.
In der Praxis bedeutet das: Das System erkennt Muster, die in Ticketprotokollen niemals sichtbar wären. TeamViewer Session Insights nutzt beispielsweise KI, um die konkreten Schritte während einer Remote-Session zu beobachten. So wird jede manuelle Fehlerbehebung zu einem Signal. Wenn mehrere Teammitglieder ähnliche Probleme lösen, entstehen Muster, die zeigen, was automatisiert werden sollte und welche Risiken sich abzeichnen.
„Wenn mehrere Leute mehrmals das dasselbe Problem auf mehreren Geräten beheben müssen, erfahren wir, welche manuellen Aufgaben das Team übernimmt“, erklärt Keogh. „Das zeigt uns, was wir automatisieren sollten.“
Das Ergebnis ist ein kontinuierlicher Feedback-Kreislauf. Bekannte Probleme werden automatisiert behoben und neue Probleme früher sichtbar. So müssen IT-Teams nicht mehr im Nachhinein auf Störungen reagieren, sondern können verhindern, dass sie sich überhaupt auf die User auswirken.
Von der MTTR zur Voraussicht
Können IT-Teams Vorfälle vorhersagen und verhindern, statt sie nur schnell zu beheben, verliert die MTTR an Bedeutung. Die mittlere Betriebsdauer zwischen Ausfällen (MTBF) wird zum entscheidenden Indikator: Sie zeigt, wie lange Systeme stabil laufen. Eine verbesserte MTBF belegt, dass die vorausschauende Strategie wirkt. Die MTTR bleibt relevant, wenn Probleme tatsächlich auftreten, ist aber nicht mehr der wichtigste Faktor.
„Die mittlere Lösungszeit verliert bei dieser Arbeitsweise an Bedeutung, weil wir verhindern, dass Tickets überhaupt erst entstehen“, sagt Keogh. „Wichtiger ist zu beobachten, wie viele Probleme wir autonom lösen. Wie viele Tickets vermeiden wir? Wie viel Zeit geben wir unseren Usern zurück?“
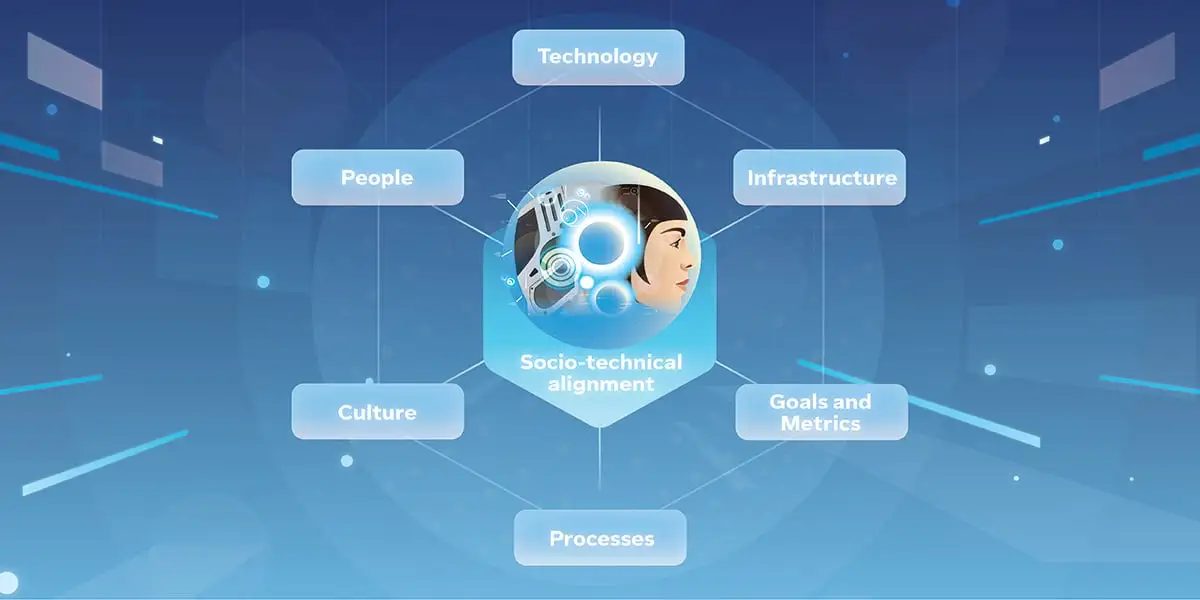
Dieser Wandel erfordert mehr als nur neue Tools. Entscheidend ist es, vier miteinander vernetzte Kompetenzen zu entwickeln, die sich gegenseitig verstärken und ein System formen, das mit der Zeit immer intelligenter wird.
So gelingt Ihnen der Umstieg auf eine vorausschauend arbeitende IT.
Erstreaktion und Wiederherstellung effizient gestalten
Auch bei einer vorausschauenden Strategie gilt: Wenn etwas ausfällt, muss das Problem zuverlässig behoben werden. Die Reaktion auf Vorfälle sollte standardisiert ablaufen. Sie benötigen außerdem die passenden Tools, um Störungen schnell zu diagnostizieren und Systeme aus der Ferne wiederherzustellen. Dadurch lassen sich Auswirkungen minimieren und wertvolle IT-Ressourcen schonen. Probleme schnell zu lösen, ist wichtig. Doch ebenso entscheidend ist es, darüber hinaus systematische Verbesserungen voranzutreiben.
Systematische Fehlerdiagnose standardisieren
Jeder schwerwiegende Vorfall ist ein Chance zu lernen. Etablieren Sie einen obligatorischen, ergebnisoffenen Analyseprozess, um die systematische Schwachstelle zu identifizieren, die den Vorfall überhaupt ermöglicht hat. Die zentrale Frage lautet nicht „Was ist kaputtgegangen?“, sondern „Warum war das möglich und wie lässt sich sicherstellen, dass es nicht wieder passiert?“
Kapazitäten für dauerhafte Lösungen bereitstellen
Bauen Sie ein formales, hoch priorisiertes Backlog für bereits identifizierte Ursachen auf. So stellen Sie sicher, dass Wartungs- und Automatisierungsaufgaben wie Aktualisierungen, Patches und die Standardisierung von Konfigurationen Vorrang vor neuen, nicht essenziellen Feature-Anfragen erhalten. Wenn ständig neue Funktionen entwickelt werden, während die Basis weiterhin instabil bleibt, lässt sich der reaktive Kreislauf nicht durchbrechen.
KPIs auf Zuverlässigkeit ausrichten
Messen Sie Ihren Erfolg anhand der mittleren Betriebsdauer zwischen Ausfällen (Mean Time Between Failures, MTBF), nicht mehr anhand der Lösungszeit (MTTR). Wird Zuverlässigkeit zur zentralen Kennzahl, rückt die Fähigkeit zur Prognose in den Mittelpunkt.
Wenn Systeme seltener ausfallen, zeigt sich der Mehrwert in der Zeit, die Menschen gar nicht erst verlieren. Gerade in Umgebungen, in denen jede Minute zählt, summiert sich dieser Unterschied schnell.
In einer Gesundheitseinrichtung meldet sich das medizinische Personal beispielsweise im Laufe des Tages an PCs in Patientenzimmern an, wobei jeweils ein User-Profil erstellt wird. Mit der Zeit sammeln sich Dutzende von Profilen auf jedem Rechner, wodurch die Startzeit von 10 Sekunden auf 2 bis 3 Minuten steigt.
„Jedes Mal, wenn eine weitere Person diesen Raum betritt, gehen zwei Minuten verloren“, erklärt Keogh. „Über mehrere Tage hinweg summiert sich das auf ein bis zwei Stunden pro Tag.“ Durch die automatische Identifizierung und Eliminierung dieser Profile erhält das medizinische Personal wertvolle Zeit zurück. „Das ist, als würde man dem Krankenhaus Dutzende zusätzlicher Pflegekräfte und ärztliches Personal zur Verfügung stellen. Mehr Produktivität bedeutet also auch einen Zuwachs an effektiv geleisteten Arbeitsstunden, so als hätte man mehr Mitarbeitende eingestellt.“
So werden nicht einfach Störungen schneller behoben. Das ist vorausschauendes Handeln, das messbaren Geschäftswert schafft.